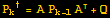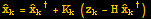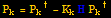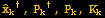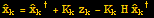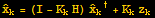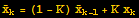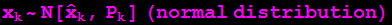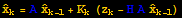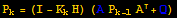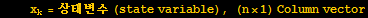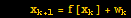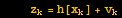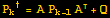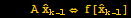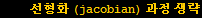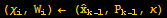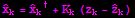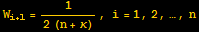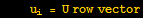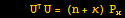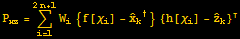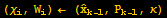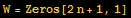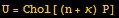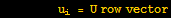
Kalman Filter

선형 시스템 모델

    x_ (k + 1) = A x_k + w_k

    z_k = H x_k + v_k

0. 초기값 선정

Overscript[x,^] _0, P_0

1. 추정값 예측, 오차 공분산 예측

Overscript[x,^] _k^† = AOverscript[x,^] _ (k - 1)

P_k^† = A P_ (k - 1) A + Q

2. 칼만 이득 계산

K_k = P_k^†H (H P_k^†H + R)^(-1)

3. 추정값 계산 (측정값 z_k → 추정값 Overscript[x,^] _k)

Overscript[x,^] _k = Overscript[x,^] _k^† + K_k (z_k - HOverscript[x,^] _k^†)

4. 오차 공분산 계산

P_k = P_k^† - K_kH P_k^†

Kalman Filter Algorithm

0. 초기값 선정

Overscript[x,^] _0, P_0

예측과정

1. 추정값 예측, 오차 공분산 예측

Overscript[x,^] _k^† = AOverscript[x,^] _ (k - 1)

P_k^† = A P_ (k - 1) A + Q

추정과정

2. 칼만 이득 계산

K_k = P_k^†H (H P_k^†H + R)^(-1)

3. 추정값 계산 (측정값 z_k → 추정값 Overscript[x,^] _k)

Overscript[x,^] _k = Overscript[x,^] _k^† + K_k (z_k - HOverscript[x,^] _k^†)

4. 오차 공분산 계산

P_k = P_k^† - K_kH P_k^†

용도별 변수

외부입력

z_k (측정값)

최종 출력

Overscript[x,^] _k (추정값)

시스템 모델

A, H, Q, R

내부 계산용

Overscript[x,^] _k^†, P_k^†, P_k, K_k

추정값과 오차 공분산

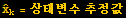
Overscript[x,^] _k = 상태변수 추정값

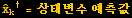
Overscript[x,^] _k^† = 상태변수 예측값

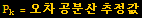
P_k = 오차 공분산 추정값

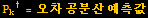
P_k^† = 오차 공분산 예측값

추정값 계산

Overscript[x,^] _k = Overscript[x,^] _k^† + K_k (z_k - HOverscript[x,^] _k^†)

Overscript[x,^] _k = Overscript[x,^] _k^† + K_kz_k - K_kHOverscript[x,^] _k^†

Overscript[x,^] _k = (I - K_kH) Overscript[x,^] _k^† + K_kz_k

Overscript[x, _] _k = αOverscript[x, _] _ (k - 1) + (1 - α) x_k

    α = 1 - K

Overscript[x, _] _k = (1 - K) Overscript[x, _] _ (k - 1) + K x_k

x_k ~ N[Overscript[x,^] _k, P_k] (normal distribution)

오차 공분산

P_k = E {(x_k - Overscript[x,^] _k) (x_k - Overscript[x,^] _k) }

추정과정

2. 칼만 이득 계산

K_k = (A P_ (k - 1) A + Q) H (H (A P_ (k - 1) A + Q) H + R)^(-1)

3. 추정값 계산 (측정값 z_k → 추정값 Overscript[x,^] _k)

Overscript[x,^] _k = AOverscript[x,^] _ (k - 1) + K_k (z_k - H AOverscript[x,^] _ (k - 1))

(z_k - H AOverscript[x,^] _ (k - 1)) 측정값의 예측 오차

Overscript[x,^] _k = (I - K_kH) AOverscript[x,^] _ (k - 1) + K_kz_k

4. 오차 공분산 계산

P_k = (I - K_kH) (A P_ (k - 1) A + Q)

시스템 모델 - 실제 시스템 모델과 비슷하게 설계

x_ (k + 1) = A x_k + w_k

z_k = H x_k + v_k

    x_k = 상태변수 (state variable), (n×1) Column vector

    z_k = 측정값 (sensor), (m×1) Column vector

    A = 상태전이행렬 (System 운동방정식), (n×n) Matrix

    H = (m×n) Matrix

    w_k = 잡음 (system white noise), (n×1) Column vector

    v_k = 잡음 (sensor noise), (m×1) Column vector

    Q = w_k의 공분산 행렬, (n×n) diagonal matrix (대각행렬)

    R = v_k의 공분산 행렬, (m×m) diagonal matrix

Extended Kalman Filter, EKF

비선형 시스템 → 선형화

선형화 칼만 필터 (Linearized Kalman Filter)

    x_ (k + 1) = f[x_k] + w_k

    z_k = h[x_k] + v_k

0. 초기값 선정

Overscript[x,^] _0, P_0

1. 추정값 예측, 오차 공분산 예측

Overscript[x,^] _k^† = f[Overscript[x,^] _ (k - 1)]

P_k^† = A P_ (k - 1) A + Q

2. 칼만 이득 계산

K_k = P_k^†H (H P_k^†H + R)^(-1)

3. 추정값 계산 (측정값 z_k → 추정값 Overscript[x,^] _k)

Overscript[x,^] _k = Overscript[x,^] _k^† + K_k (z_k - h[Overscript[x,^] _k^†])

4. 오차 공분산 계산

P_k = P_k^† - K_kH P_k^†

Jacobian Matrix

    A Overscript[x,^] _ (k - 1) ⇔ f[Overscript[x,^] _ (k - 1)]

    H Overscript[x,^] _k^†⇔ h[Overscript[x,^] _k^†]

A≡∂f/∂x[Overscript[x,^] _k]

H≡∂h/∂x[Overscript[x,^] _k^†]

Unscented Kalman Filter

    선형화 (jacobian) 과정 생략

0. 초기값 선정

Overscript[x,^] _0, P_0

1. 시그마 포인트와 가중치 계산

(χ_i, W_i) ← (Overscript[x,^] _ (k - 1), P_ (k - 1), κ)

2. 추정값 예측, 오차 공분산 예측

(Overscript[x,^] _k^†, P_k^†) = UT[f[χ_i], W_i, Q]

3. 추정값 예측, 오차 공분산 예측

(Overscript[z,^] _k, P_z) = UT[h[χ_i], W_i, R]

4. 칼만 이득 계산

P_xz = Underoverscript[∑, i = 1, arg3] W_i {f[χ_i] - Overscript[x,^] _k^†} {h[χ_i] - Overscript[z,^] _k} 

K_k = P_xzP_z^(-1)

5. 추정값 계산 (측정값 z_k → 추정값 Overscript[x,^] _k)

Overscript[x,^] _k = Overscript[x,^] _k^† + K_k (z_k - Overscript[z,^] _k)

6. 오차 공분산 계산

P_k = P_k^† - K_kH P_k^†

x ~ N[x_m, P_k]

    Monte Carlo Simulation

χ_1 = x_m

χ_ (i + 1) = x_m + u_i, i = 1, 2, …, n

χ_ (i + n + 1) = x_m - u_i, i = 1, 2, …, n

W_1 = κ/(n + κ)

W_ (i + 1) = 1/(2 (n + κ)), i = 1, 2, …, n

W_ (i + n + 1) = 1/(2 (n + κ)), i = 1, 2, …, n

    χ = kai

    κ = kappa

    u_i = U row vector

    Cholesky decomposition (분해)

    UU = (n + κ) P_x

y=f[x]의 평균과 공분산 ⇒ 시그마 포인트와 가중치
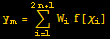
y_m = Underoverscript[∑, i = 1, arg3] W_if[χ_i]

P_y = Underoverscript[∑, i = 1, arg3] W_i {f[χ_i] - y_m} {f[χ_i] - y_m} 

    weighted mean

x_m = Underoverscript[∑, i = 1, arg3] W_iχ_i

P_y = Underoverscript[∑, i = 1, arg3] W_i {χ_i - x_m} {χ_i - x_m} 

P_xz = Underoverscript[∑, i = 1, arg3] W_i {f[χ_i] - Overscript[x,^] _k^†} {h[χ_i] - Overscript[z,^] _k} 

SigmaPoints

(χ_i, W_i) ← (Overscript[x,^] _ (k - 1), P_ (k - 1), κ)

n = numel[Overscript[x,^] _ (k - 1)]

χ_i = Zeros[n, 2n + 1]

W = Zeros[2n + 1, 1]

χ_i (:, 1) = Overscript[x,^] _ (k - 1)

W (1) = κ/(n + κ)

U = Chol[(n + κ) P]

    UU = (n + κ) P

for k = 1 : n

    χ_ (k + 1) = Overscript[x,^] _ (k - 1) + U_k

        u_i = U row vector

        χ_i (:, k + 1) = Overscript[x,^] _ (k - 1) + U (k, :) 

    W (k + 1) = 1/(2 (n + κ))

for k = 1 : n

    χ_ (n + k + 1) = Overscript[x,^] _ (k - 1) - U_k

        χ_i (:, n + k + 1) = Overscript[x,^] _ (k - 1) - U (k, :) 

    W (n + k + 1) = 1/(2 (n + κ))

UT

(Overscript[x,^] _k^†, P_k^†) = UT[f[χ_i], W_i, Q]

(Overscript[z,^] _k, P_z) = UT[h[χ_i], W_i, R]

        χ_i = χ (:, i)         W_i = W (i)

    x_m = Underoverscript[∑, i = 1, arg3] W_iχ_i

         (n×n) matrix

    P_y = Underoverscript[∑, i = 1, arg3] W_i {χ_i - x_m} {χ_i - x_m} 