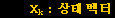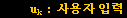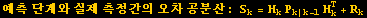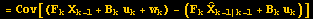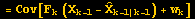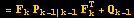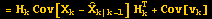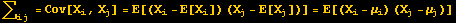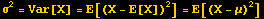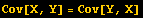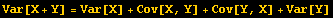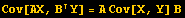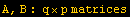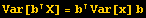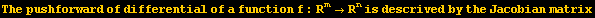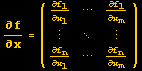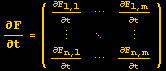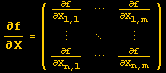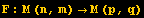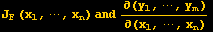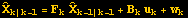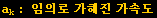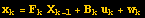
Kalman Filter

이산 시간 선형 동적 시스템 모델

x_k = F_kX_ (k - 1) + B_ku_k + w_k

    X_k : 상태 벡터

    B_k : 사용자 입력에 의한 상태 전이 행렬

    u_k : 사용자 입력

z_k = H_kX_k + v_k

    H_k : 해당 시간에서 측정에 관계되는 행렬

칼만 필터의 구조

Overscript[X,^] _ (k | k) : k시점의 측정 값을 토대로 한 k시점의 상태 추정값

P_ (k | k) : k시점의 측정값을 토대로 한 k시점의 상태 공분산행렬

    n|m: m시점에서의 측정값을 토대로 한 n시점의 상태 추정을 의미한다.

예측단계 Predict

예측 단계의 계산은 연역적으로 이루어짐

Predicted (a priori) state estimate

연역적 상태 예측 : Overscript[X,^] _ (k | k - 1) = F_kOverscript[X,^] _ (k - 1 | k - 1) + B_ku_k

Predicted (a priori) estimate covariance

연역적 공분산 예측 : P_ (k | k - 1) = F_kP_ (k - 1 | k - 1) F_k^T + Q_ (k - 1)

보정단계 Update

보정단계에서는 앞단계의 예측 값과 실제 측정값간의 오차를 이용해,이전에 얻은 값을 귀납적으로 수정

Innovation or measurement residual

예측 단계와 실제 측정간의 오차 : Overscript[y,^] _k = z_k - H_kOverscript[X,^] _ (k | k - 1)

Innovation (or residual) covariance

예측 단계와 실제 측정간의 오차 공분산 : S_k = H_kP_ (k | k - 1) H_k^T + R_k

Optimal Kalman gain

최적 칼만 게인 (Kalman gain) : K_k = P_ (k | k - 1) H_k^TS_k^(-1)

Updated (a posteriori) state estimate

귀납적 상태 보정 : Overscript[X,^] _ (k | k) = Overscript[X,^] _ (k | k - 1) + K_k Overscript[y,^] _k

Updated (a posteriori) estimate covariance

귀납적 공분산 보정 : P_ (k | k) = (I - K_kH_k) P_ (k | k - 1)

불변량 Invariants

E[X_k - Overscript[X,^] _ (k | k)] = E[X_k - Overscript[X,^] _ (k | k - 1)] = 0

E[Overscript[y,^] _k] = 0

여기서 E[ζ]은 ζ의 기대값이고,공분산 매트릭스는 정확하게 추정의 공분산을 반영

P_ (k | k) = Cov[X_k - Overscript[X,^] _ (k | k)]

P_ (k | k - 1) = Cov[X_k - Overscript[X,^] _ (k | k - 1)]

S_k = Cov[Overscript[y,^] _k]

Derivations

연역적 공분산 예측 유도

P_ (k | k - 1) = Cov[X_k - Overscript[X,^] _ (k | k - 1)]

= Cov[(F_kX_ (k - 1) + B_ku_k + w_k) - (F_kOverscript[X,^] _ (k - 1 | k - 1) + B_ku_k)]

= Cov[F_k (X_ (k - 1) - Overscript[X,^] _ (k - 1 | k - 1)) + w_k]

= F_kCov[X_ (k - 1) - Overscript[X,^] _ (k - 1 | k - 1)] F_k^T + Cov[w_k]

= F_kP_ (k - 1 | k - 1) F_k^T + Q_ (k - 1)

예측 단계와 실제 측정간의 오차 공분산 유도

S_k = Cov[Overscript[y,^] _k]

= Cov[(z_k - H_kOverscript[X,^] _ (k | k - 1))]

= Cov[H_kX_k + v_k - H_kOverscript[X,^] _ (k | k - 1)]

= Cov[H_k (X_k - Overscript[X,^] _ (k | k - 1)) + v_k]

= H_kCov[X_k - Overscript[X,^] _ (k | k - 1)] H_k^T + Cov[v_k]

= H_kP_ (k | k - 1) H_k^T + R_k

후부 추정 공분산(posterior estimate covariance) matrix 유도
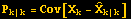
P_ (k | k) = Cov[X_k - Overscript[X,^] _ (k | k)]

P_ (k | k) = Cov[X_k - (Overscript[X,^] _ (k | k - 1) + K_k Overscript[y,^] _k)]

P_ (k | k) = Cov[X_k - (Overscript[X,^] _ (k | k - 1) + K_k (z_k - H_kOverscript[X,^] _ (k | k - 1)))]

P_ (k | k) = Cov[X_k - (Overscript[X,^] _ (k | k - 1) + K_k (H_kX_k + v_k - H_kOverscript[X,^] _ (k | k - 1)))]

P_ (k | k) = Cov[(X_k - Overscript[X,^] _ (k | k - 1)) - K_kH_k (X_k - Overscript[X,^] _ (k | k - 1)) - K_kv_k]

P_ (k | k) = Cov[(I - K_kH_k) (X_k - Overscript[X,^] _ (k | k - 1)) - K_kv_k]

P_ (k | k) = Cov[(I - K_kH_k) (X_k - Overscript[X,^] _ (k | k - 1))] + Cov[K_kv_k]

P_ (k | k) = (I - K_kH_k) Cov[X_k - Overscript[X,^] _ (k | k - 1)] (I - K_kH_k)^T + K_kCov[v_k] K_k^T

P_ (k | k) = (I - K_kH_k) P_ (k | k - 1) (I - K_kH_k)^T + K_kR_kK_k^T

칼만 이득 K_k 유도

칼만 필터는 최소 자승 에러 (minimum mean - square error, MMSE) 추정

후부 상태 추정에서 에러

X_k - Overscript[X,^] _ (k | k)   

에러 자승의 기대값 최소화하는 것을 찾는다

E[(X_k - Overscript[X,^] _ (k | k))^2]

P_ (k | k) = (I - K_kH_k) P_ (k | k - 1) (I - K_kH_k)^T + K_kR_kK_k^T

= P_ (k | k - 1) - K_kH_kP_ (k | k - 1) - P_ (k | k - 1) H_k^TK_k^T + K_kH_kP_ (k | k - 1) H_k^TK_k^T + K_kR_kK_k^T

= P_ (k | k - 1) - K_kH_kP_ (k | k - 1) - P_ (k | k - 1) H_k^TK_k^T + K_k (H_kP_ (k | k - 1) H_k^T + R_k) K_k^T

= P_ (k | k - 1) - K_kH_kP_ (k | k - 1) - P_ (k | k - 1) H_k^TK_k^T + K_kS_kK_k^T

그 트레이스는 매트릭스 유도체(매트릭스 미분(calculus))가 0일 때 최소화 됨

tr (P_ (k | k)) = tr (P_ (k | k - 1) - K_kH_kP_ (k | k - 1) - P_ (k | k - 1) H_k^TK_k^T + K_kS_kK_k^T)

= tr (P_ (k | k - 1)) - 2tr (K_kH_kP_ (k | k - 1)) + tr (K_kS_kK_k^T)

(∂ tr (P_ (k | k)))/∂ K_k = ∂ (tr (P_ (k | k - 1)) - 2tr (K_kH_kP_ (k | k - 1)) + tr (K_kS_kK_k^T))/∂ K_k

= (∂ tr (P_ (k | k - 1)) - 2∂ tr (K_kH_kP_ (k | k - 1)) + ∂ tr (K_kS_kK_k^T))/∂ K_k

= (∂ tr (P_ (k | k - 1)))/∂ K_k - 2 (∂ tr (K_kH_kP_ (k | k - 1)))/∂ K_k + (∂ tr (K_kS_kK_k^T))/∂ K_k

= -2 (∂ tr (K_kH_kP_ (k | k - 1)))/∂ K_k + (∂ tr (K_kS_kK_k^T))/∂ K_k

= -2 (H_kP_ (k | k - 1))^T + 2K_kS_k

(∂tr (AC))/∂A = C

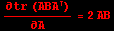
(∂tr (ABA))/∂A = 2AB

(∂ tr (P_ (k | k)))/∂ K_k = -2 (H_kP_ (k | k - 1))^T + 2K_kS_k = 0

K_kS_k = (H_kP_ (k | k - 1))^T = P_ (k | k - 1) H_k^T

K_k = P_ (k | k - 1) H_k^TS_k^(-1)

최적의 칼만 이득이라 불리는,이 이득은 MMSE 추정을 사용했을 때 산출되는 값

후부 에러 공분산(posterior error covariance) 식의 간이화  

칼만 이득이 위에서 이끌어 낸 최적의 값과 같을 때 후부 에러 공분산을
단순화할 수 있도록 계산하기 위해 공식을 사용

S_kK_k^T을 칼만 게인 수식의 양쪽 모두에 곱하면

K_kS_kK_k^T = P_ (k | k - 1) H_k^TK_k^T

P_ (k | k) = P_ (k | k - 1) - K_kH_kP_ (k | k - 1) - P_ (k | k - 1) H_k^TK_k^T + K_kS_kK_k^T

= P_ (k | k - 1) - K_kH_kP_ (k | k - 1) - P_ (k | k - 1) H_k^TK_k^T + P_ (k | k - 1) H_k^TK_k^T

= P_ (k | k - 1) - K_kH_kP_ (k | k - 1)

= (I - K_kH_k) P_ (k | k - 1)

이 공식은 계산 량이 적고 거의 항상 실제에 사용되지만,최적의 이득에서 옳을 뿐이다.만약 수치 정밀도가 수치안정에 문제를 야기하는 것에 대한 영향이 적지만은 않다면,최적이 아닌 칼만 이득이 고의로 사용된다면,이 단순화 과정은 지원될 수 없다.위에서 이끌어낸 후부 에러 공분산 공식을 사용해야만 한다.

EKF - Extended Kalman Filter

x_k = f (X_ (k - 1), u_ (k - 1)) + w_ (k - 1)

z_k = h (X_k) + v_k

f, h 미분 가능한 함수

Predict

예측된 상태 : Overscript[X,^] _ (k | k - 1) = f (Overscript[X,^] _ (k - 1 | k - 1), u_k)

예측된 추정 공분산 : P_ (k | k - 1) = F_ (k - 1) P_ (k - 1 | k - 1) F_ (k - 1)^T + Q_ (k - 1)

Update

혁신 혹은 추정 나머지 : Overscript[y,^] _k = z_k - h (Overscript[X,^] _ (k | k - 1))

혁신 혹은 추정 공분산 : S_k = H_kP_ (k | k - 1) H_k^T + R_k

최적 칼만 게인 (Kalman gain) : K_k = P_ (k | k - 1) H_k^TS_k^(-1)

업데이트된 상태 추정 : Overscript[X,^] _ (k | k) = Overscript[X,^] _ (k | k - 1) + K_k Overscript[y,^] _k

업데이트된추정 공분산 : P_ (k | k) = (I - K_kH_k) P_ (k | k - 1)

상태 변이와 관측 매트릭스는 자코비안에 따라 정의

F_ (k - 1) = ∂f/∂x | _ (Overscript[X,^] _ (k - 1 | k - 1), u_k)

H_k = ∂h/∂x | _Overscript[X,^] _ (k - 1 | k - 1)

Covariance

공분산 - 상관관계

Cov[X, Y] = E[(X - E[X]) (Y - E[Y])]

Cov[X, Y] = E[X Y] - E[X] E[Y]

Cov[X, Y] = E[(X - E[X]) (Y - E[Y]) ]

Cov[X, Y] = E[X Y] - E[X] E[Y] 

Cov[X, 0] = 0

Cov[X, X] = Var[X]

Cov[X, Y] = Cov[Y, X]

Cov[aX, bY] = ab Cov[X, Y]

Cov[X + a, Y + b] = Cov[X, Y]

Cov[aX + bY, cW + dV] = ac Cov[X, W] + ad Cov[X, V] + bc Cov[Y, W] + bd Cov[Y, V]

Cov[X_i, X_j] = E[(X_i - E[X_i]) (X_j - E[X_j])] = E[X_i X_j] - E[X_i] ·E[X_j]

공분산행렬

X = ({{X_1}, {:}, {X_n}})

∑_ (i j) = Cov[X_i, X_j] = E[(X_i - E[X_i]) (X_j - E[X_j])] = E[(X_i - μ_i) (X_j - μ_j)]

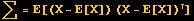
∑ = E[(X - E[X]) (X - E[X]) ]

σ^2 = Var[X] = E[(X - E[X])^2] = E[(X - μ)^2]

μ = E[X]

Var[X] = Cov[X] = E[(X - E[X]) (X - E[X]) ]

Cov[X, Y] = E[(X - μ) (Y - ν) ]

∑ = E[(X - E[X]) (X - E[X]) ], μ = E[X]

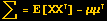
∑ = E[XX] - μμ

Var[AX + a] = A Var[X] A

Cov[X, Y] = Cov[Y, X]

Cov[X_1 + X_2, Y] = Cov[X_1, Y] + Cov[X_2, Y]

Var[X + Y] = Var[X] + Cov[X, Y] + Cov[Y, X] + Var[Y]

Cov[AX, BY] = A Cov[X, Y] B

X, X_1, X_2 : p×1 vector

Y : q×1 vector

a : q×1 vector

A, B : q×p matrices

c∑ = Cov[cX, X]

d∑c = Cov[dX, cX]

Var[bX] = bVar[x] b

Matrix, Derivative, det, tr

The product of the eigenvalues is equal to the determinant of A

det[A] = Underoverscript[∏, i = 1, arg3] λ_i^n_i

The sum of the eigenvalues is equal to the trace of A
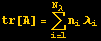
tr[A] = Underoverscript[∑, i = 1, arg3] n_iλ_i

Vector calculus

The tangent vector to a curve x : R→R^n

∂x/∂t = ({{∂x_1/∂t}, {:}, {∂x_n/∂t}})

The gradient of a scalar function f : R^n→R

∂f/∂x = ({{∂f/∂x_1, ···, ∂f/∂x_n}})

The directional derivative of f in the direction of v is then

∇_vf = ∂f/∂xv

The pushforward of differential of a function f : R^m→R^n is descrived by the Jacobian matrix

∂f/∂x = ({{∂f_1/∂x_1, ···, ∂f_1/∂x_m}, {:, ·., :}, {∂f_n/∂x_1, ···, ∂f_n/∂x_m}})

The pushforward along f of a vector v in R^m

d f (v) = ∂f/∂xv

Matrix calculus

The tangent vector of a curve F : R→M (n, m)

The gradient of a scalar function f : M (n, m) →R

∇_Yf = tr[∂f/∂xY]

F : M (n, m) →M (p, q)

dF (Y) = tr (∂F/∂XY)

Jacobian matrix

D F (x) = (∂ vec F (X))/∂ (vec X) 

Chain rule

∂Z/∂X = ∂Z/∂Y∂Y/∂X

Product rule

∂ (YZ)/∂X = ∂Y/∂XZ + Y∂Z/∂X

Derivative of linear functions

(∂ax)/∂x = (∂xa)/∂x = a

∂Ax/∂x = (∂xA)/∂x = A

Derivative of quadratic functions

(∂xAx)/∂x = x (A + A) = xA + XA

(∂ (Ax + b) C (Dx + e))/∂x = (Dx + e) CA + (Ax + b) CD

∂ | x - a |/∂x = (x - a) /(| x - a |)

Derivative of matrix traces

(∂tr (AC))/∂A = C

(∂tr (AXB))/∂X = (∂tr (BXA))/∂X = BA

(∂tr (ABA))/∂A = 2AB

(∂tr (AXBXC))/∂X = BXCA + BXAC

Derivative of matrix determinant

(∂det X)/∂X = adj X = det X·X^(-1)

Jacobian matrix

F : R^n→R^m

J = ({{∂y_1/∂x_1, ···, ∂y_1/∂x_n}, {:, ·., :}, {∂y_m/∂x_1, :, ∂y_m/∂x_n}})

J_F (x_1, ···, x_n) and ∂ (y_1, ···, y_m)/∂ (x_1, ···, x_n)

F (x) = F (p) + J_F (p) (x - p) + o (| x - p |)

ex1

x_1 = r Sin[θ] Cos[φ]

x_2 = r Sin[θ] Sin[φ]

x_3 = r Cos[θ]

ex2

x = r Cos[φ]

y = r Sin[φ]

J_F (r, φ) = ({{∂x/∂r, ∂x/∂φ}, {∂y/∂r, ∂y/∂φ}}) = ({{Cos[φ], -r Sin[φ]}, {Sin[φ], r Cos[φ]}})

∫∫_Axy = ∫∫_Br rφ

ex3

F : R^n→R^m

y_1 = F_1 (x_1, ···, x_n)

:

y_m = F_m (x_1, ···, x_n)

J_F (x_1, ···, x_n) = ({{∂y_1/∂x_1, ···, ∂y_1/∂x_n}, {:, ·., :}, {∂y_m/∂x_1, :, ∂y_m/∂x_n}})

Ex.

Overscript[X,^] _ (k | k - 1) = F_kOverscript[X,^] _ (k - 1 | k - 1) + B_ku_k + w_k

X_k = ({{x_k}, {Overscript[x, .] _k}})

x_k : k시점에서의 위치

Overscript[x, .] _k : k시점에서의 속도

a_k : 임의로 가해진 가속도

뉴턴의 운동법칙

x_k = x_ (k - 1) + Overscript[x, .] _ (k - 1) dt + a_kdt^2/2

Overscript[x, .] _k = Overscript[x, .] _ (k - 1) + a_kdt

X_k = F X_ (k - 1) + w_k

w_k = B a_k

F = ({{1, dt}, {0, 1}})

B = ({{dt^2/2}, {dt}})

Q = Cov[B a_k] = E[(B a) (B a)^T] = B E[a^2] B^T = B [σ_a^2] B^T = σ_a^2B B^T = ({{dt^4/4, dt^3/2}, {dt^3/2, dt^2}}) σ_a^2

z_k = H_kx_k + v_k

H = ({{1, 0}})

R = E[v_kv_k^T] =[σ_z^2]

Overscript[X,^] _ (0 | 0) = ({{0}, {0}})

P_ (0 | 0) = ({{L, 0}, {0, L}})

http://ko.wikipedia.org/wiki/%EC%B9%BC%EB%A7%8C_%ED%95%84%ED%84%B0